Pythonでデータを扱っていると、リスト内に同じ値が複数入ることがあります。
例えば、ユーザーが入力した名前、商品のカテゴリー、検索結果などをまとめると、同じデータが重複する場合があります。
Pythonでは、「dict.fromkeys()」や「set()」を使って重複を削除できます。ただし、元の順番を残したいかどうかによって適切な方法が変わります。
この記事では、リストから重複する要素を削除する方法と、それぞれの違いを初心者向けに解説します。
dict.fromkeys()で順番を保って重複を削除する
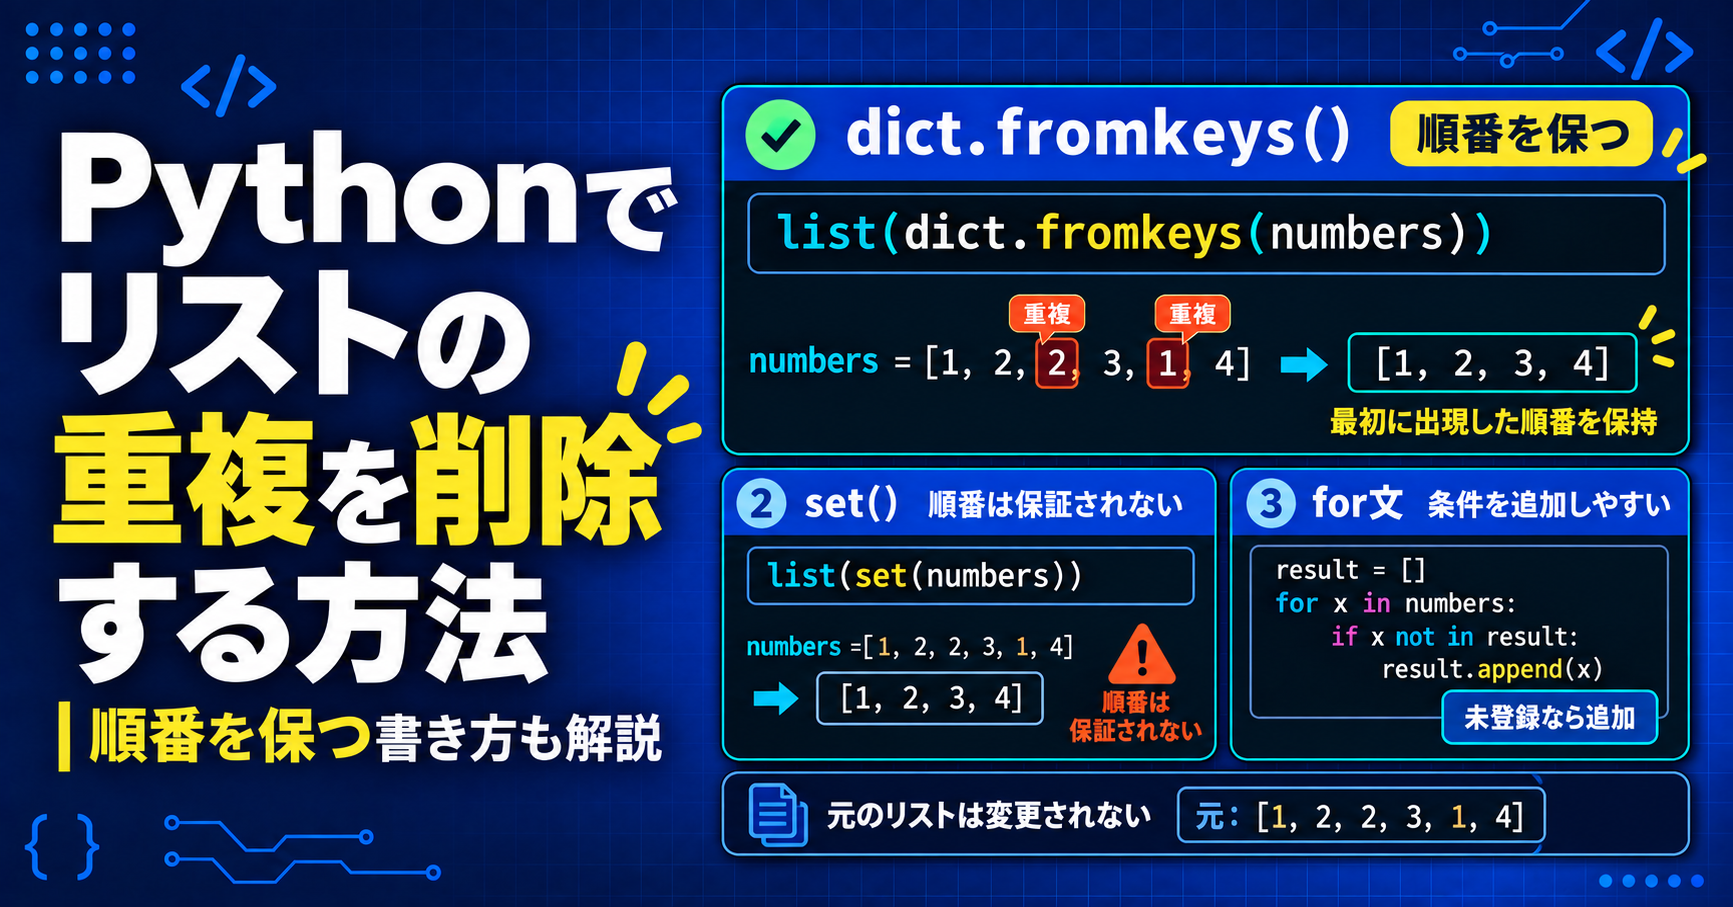
元の順番を保ったまま重複を削除したい場合は、「dict.fromkeys()」を使う方法が便利です。
# 重複を含むリスト
numbers = [1, 2, 2, 3, 1, 4]

# 順番を保ったまま重複を削除
unique_numbers = list(dict.fromkeys(numbers))

print(unique_numbers)  # [1, 2, 3, 4]
このコードでは、最初に登場した要素だけが残ります。
元のリスト:[1, 2, 2, 3, 1, 4]
処理後 :[1, 2, 3, 4]2回目の「2」と2回目の「1」が削除され、最初に登場した位置の順番が保たれています。
文字列のリストでも同じように使えます。
# 重複する商品名を含むリスト
items = ["りんご", "牛乳", "りんご", "パン", "牛乳"]

# 最初に登場した商品名だけを残す
unique_items = list(dict.fromkeys(items))

print(unique_items)  # ['りんご', '牛乳', 'パン']
順番を残したい場合は、まずこの方法を検討するとよいでしょう。
dict.fromkeys()で重複を削除できる仕組み
「dict.fromkeys()」は、リストの要素を辞書のキーへ変換します。
辞書では、同じキーを複数持つことができません。そのため、同じ値が2回以上登場しても1つにまとめられます。
numbers = [1, 2, 2, 3, 1, 4]

# リストの要素を辞書のキーにする
temporary_dict = dict.fromkeys(numbers)

print(temporary_dict) # {1: None, 2: None, 3: None, 4: None}この辞書を「list()」で再びリストへ変換します。
numbers = [1, 2, 2, 3, 1, 4]

temporary_dict = dict.fromkeys(numbers)

# 辞書のキーをリストへ変換
unique_numbers = list(temporary_dict)

print(unique_numbers)  # [1, 2, 3, 4]
短く書くと、次の1行になります。
unique_numbers = list(dict.fromkeys(numbers))最初は命令が重なって見えますが、「辞書で重複をなくす」「リストへ戻す」という2段階に分けると理解しやすくなります。
set()で重複を削除する
元の順番を残す必要がなければ、「set()」を使う方法もあります。
「set」は、同じ要素を重複して持たない集合です。
# 重複を含むリスト
numbers = [1, 2, 2, 3, 1, 4]

# setに変換して重複を削除し、リストへ戻す
unique_numbers = list(set(numbers))

print(unique_numbers)
重複は削除されますが、元と同じ順番になるとは限りません。
元のリスト:[1, 2, 2, 3, 1, 4]
処理後の例:[1, 2, 3, 4]
表示結果が元の順番と同じに見える場合もありますが、順番を保つ処理として使うべきではありません。
「どの値が含まれているか」だけが重要で、並び順を気にしない場合に向いています。
for文で重複を削除する
処理の仕組みを理解したい場合は、for文を使って書くこともできます。
# 重複を含むリスト
numbers = [1, 2, 2, 3, 1, 4]

# 結果を保存する空のリスト
unique_numbers = []

# 要素を順番に確認
for number in numbers:
    # まだ追加されていない場合だけ保存
    if number not in unique_numbers:
        unique_numbers.append(number)

print(unique_numbers)  # [1, 2, 3, 4]
この処理では、元のリストから要素を一つずつ取り出します。
取り出した値が「unique_numbers」に入っていなければ追加し、すでに入っていれば何もしません。
処理の流れは次のとおりです。
1:まだないため追加
2:まだないため追加
2:すでにあるため追加しない
3:まだないため追加
1:すでにあるため追加しない
4:まだないため追加for文は「dict.fromkeys()」より長くなりますが、重複を削除する仕組みが見えやすい方法です。
値を追加するときに別の条件も確認したい場合にも応用できます。
元のリストは変更されない
ここまで紹介した方法では、重複を削除した新しいリストを作っています。
numbers = [1, 2, 2, 3, 1, 4]

# 重複を削除した新しいリストを作る
unique_numbers = list(dict.fromkeys(numbers))

print(numbers)         # [1, 2, 2, 3, 1, 4]
print(unique_numbers) # [1, 2, 3, 4]元の「numbers」には、重複した値が残っています。
元の変数を重複削除後のリストへ置き換えたい場合は、同じ変数へ代入します。
numbers = [1, 2, 2, 3, 1, 4]

# 重複を削除した結果で元の変数を置き換える
numbers = list(dict.fromkeys(numbers))

print(numbers) # [1, 2, 3, 4]重複を削除するときは、「元のデータを残すか」「処理後のデータで置き換えるか」も考えておきましょう。
大文字と小文字は別の値として扱われる
文字列を比較する場合、大文字と小文字は別の値として扱われます。
names = ["apple", "Apple", "banana", "APPLE"]

unique_names = list(dict.fromkeys(names))

print(unique_names) # ['apple', 'Apple', 'banana', 'APPLE']「apple」「Apple」「APPLE」は、それぞれ異なる文字列です。そのため、このままでは重複として削除されません。
大文字と小文字を区別せず、最初に登場した表記を残したい場合は、比較用の値を別に記録します。
names = ["apple", "Apple", "banana", "APPLE"]

# 比較済みの文字列を保存
seen = set()

# 最初に登場した表記を保存
unique_names = []

for name in names:
    # 小文字に変換した値で比較
    comparison_name = name.lower()

    if comparison_name not in seen:
        seen.add(comparison_name)
        unique_names.append(name)

print(unique_names)  # ['apple', 'banana']
比較には小文字を使いますが、結果には最初に登場した元の文字列を追加しています。
データをすべて小文字へ変換するのではなく、「比較用の形」と「表示用の形」を分けているのがポイントです。
リストの中にリストがある場合
「dict.fromkeys()」や「set()」は、リスト内の要素が数値や文字列であれば利用できます。
しかし、要素そのものがリストの場合はエラーになります。
# 内側にもリストがある
numbers = [[1, 2], [3, 4], [1, 2]]

# リストは辞書のキーにできないためエラーになる
unique_numbers = list(dict.fromkeys(numbers))
このような2次元リストでは、for文を使う方法が分かりやすいでしょう。
numbers = [[1, 2], [3, 4], [1, 2]]

unique_numbers = []

# 同じ内容のリストがなければ追加
for number_list in numbers:
    if number_list not in unique_numbers:
        unique_numbers.append(number_list)

print(unique_numbers)  # [[1, 2], [3, 4]]
重複を削除する方法は、リスト内にどのようなデータが入っているかによっても変わります。
重複の判定基準を先に決める
重複を削除するときは、「何を同じデータとして扱うのか」を先に決めることが重要です。
例えば、次の文字列は見た目が似ていますが、そのままでは別の値です。
Python
python
Python
大文字と小文字が異なる場合や、末尾に空白が入っている場合、Pythonは別の文字列として扱います。
必要に応じて、「lower()」で小文字にそろえたり、「strip()」で前後の空白を取り除いたりしてから比較します。
languages = ["Python", "python", "Python ", "Java"]

# 小文字に変換し、前後の空白も削除
normalized_languages = [
    language.strip().lower()
    for language in languages
]

# 整えた値の重複を削除
unique_languages = list(dict.fromkeys(normalized_languages))

print(unique_languages) # ['python', 'java']単に重複を消すだけでなく、「どの違いを無視するのか」を決めることが、正しいデータ整理につながります。
方法の選び方
リストの重複を削除する方法は、目的に応じて選びます。
- 元の順番を保ちたい:「dict.fromkeys()」
- 順番を気にしない:「set()」
- 処理の仕組みを確認したい:for文
- 独自の条件で重複を判断したい:比較用の値を記録するfor文
- リストの中にリストがある:for文
単に最短のコードを選ぶのではなく、「順番」と「重複の判定基準」を確認してから方法を決めると、あとで意図しない結果になりにくくなります。
まとめ
Pythonでリストの重複を削除し、元の順番も保ちたい場合は、「dict.fromkeys()」を使う方法が便利です。
numbers = [1, 2, 2, 3, 1, 4]

unique_numbers = list(dict.fromkeys(numbers))

print(unique_numbers)  # [1, 2, 3, 4]
この記事で紹介したポイントは次のとおりです。
- 「dict.fromkeys()」は順番を保って重複を削除できる
- 「set()」でも重複を削除できるが、元の順番は保証されない
- for文を使うと、重複を確認する仕組みが分かりやすい
- 紹介した方法では、基本的に重複を除いた新しいリストを作る
- 大文字と小文字は異なる値として扱われる
- リストの中にリストがある場合は、for文を使う方法が分かりやすい
- 重複を削除する前に、何を同じ値として扱うか決める
重複削除では、「同じ値を1つにすること」だけでなく、「どの順番を残すか」「何を同じと判断するか」も重要です。
この2つを意識すると、データの意味を保ったまま整理できるようになります。